
Чем промпты отличаются от интентов и как устроена семантика в AI-поиске?
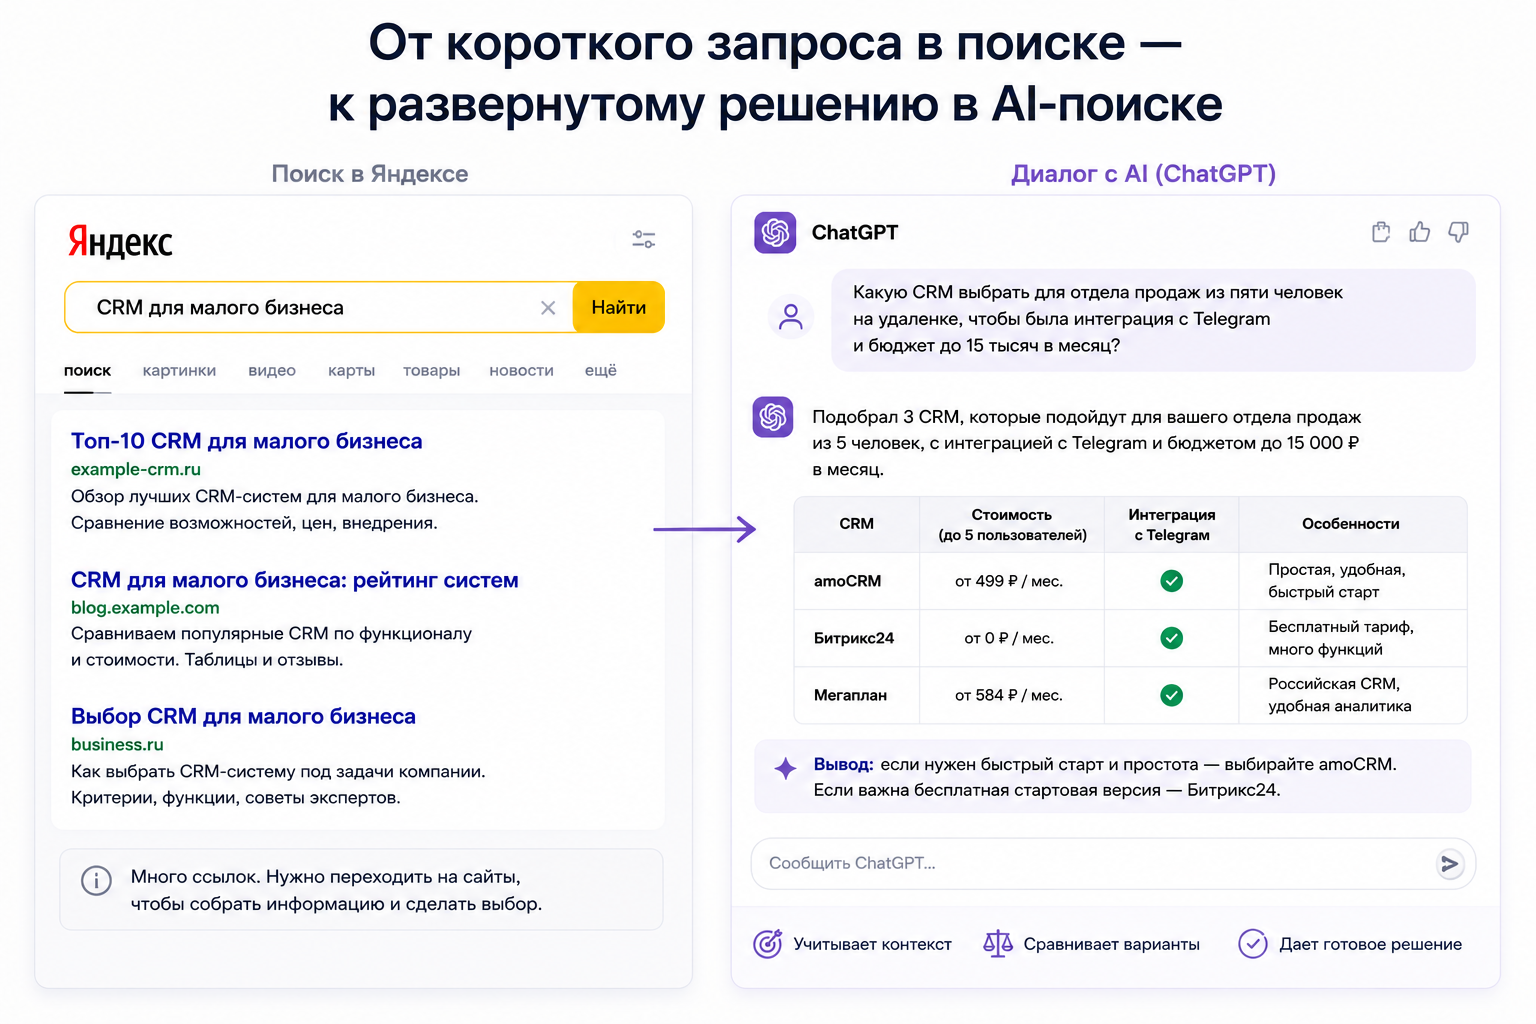 Пользователь, который раньше вводил в Яндексе «CRM для малого бизнеса», сегодня пишет в ChatGPT: «Какую CRM выбрать для отдела продаж из пяти человек на удаленке, чтобы была интеграция с Telegram и бюджет до 15 тысяч в месяц». Вторая формулировка не попадает ни в один классический кластер семантического ядра. Разбираем, чем промпт отличается от интента и поискового запроса, как нейросеть достает смысл из такой фразы и что менять в семантике и контенте.
Что такое промпт и из чего он состоит
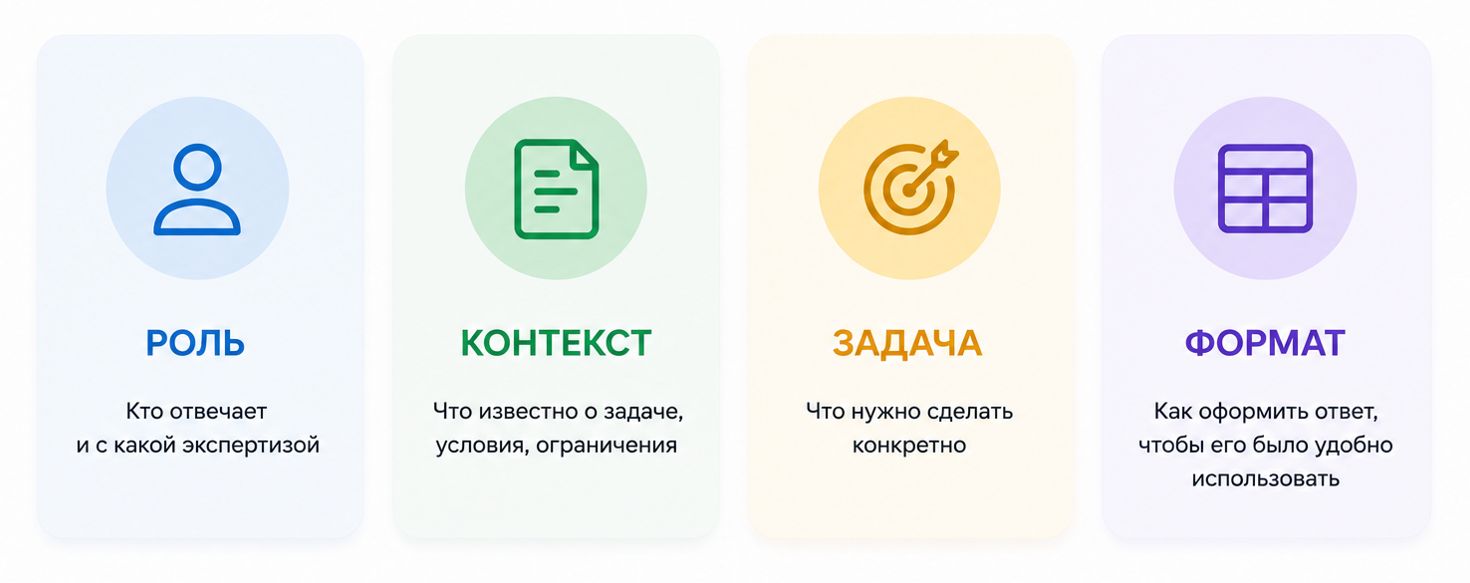
Это инструкция для нейросети, написанная естественным языком. Рабочий промпт содержит четыре элемента: роль, контекст, задачу и формат ответа.
«Ты — консультант по системам учета заявок (роль). У меня строительная компания, 12 прорабов на объектах, все работают с телефонов (контекст). Подбери три системы и объясни, чем они отличаются по цене и внедрению (задача). Ответь таблицей (формат)». Уберите любой из четырех элементов — и модель начнет достраивать недостающее сама, чаще всего усредненным вариантом.
Промпты, которые пользователи задают нейросетям при выборе товаров и услуг, можно условно разделить на пять типов:
- ситуативные — описывают конкретное положение пользователя: «переезжаю в новый офис, нужен подрядчик на монтаж СКС»;
- сравнительные — просят сопоставить варианты: «сравни Битрикс24 и amoCRM по стоимости для команды из 10 человек»;
- репутационные — проверяют надежность: «какие отзывы о компании X, были ли суды с клиентами»;
- прогностические — запрашивают оценку на будущее: «вырастут ли цены на металлопрокат к весне»;
- поисковые — ближе всего к классическим ключам, но с уточнением: «где заказать печать флагов с логотипом в Москве от 50 штук».
 Что такое интент и как он связан с промптом
Интент — намерение, с которым человек обращается к поиску или нейросети. Промпт — словесная оболочка этого намерения.
Один интент порождает десятки промптов. Человек, которому нужна система учета заявок, спросит по-разному: голосом Алисе за рулем, текстом в ChatGPT вечером с ноутбука, коротким запросом в Яндексе с телефона. Формат обращения будет разным, а задача пользователя — одной. Нейросеть объединяет такие формулировки в один смысловой кластер именно по интенту, а не по совпадению лексики.
Классическая SEO-сетка делит интенты на четыре типа:
- информационный — узнать, разобраться, понять принцип: «как работает УСН для ИП»;
- навигационный — попасть на конкретный сайт или сервис: «личный кабинет Тинькофф Бизнес»;
- коммерческий — сравнить перед покупкой: «лучшие POS-терминалы для кофейни»;
- транзакционный — купить или заказать: «заказать POS-терминал с доставкой».
В AI-поиске эта сетка сохраняется, но добавляется составной интент. Диалог из четырех реплик начинается с информационного вопроса, к третьей реплике переходит в коммерческое сравнение, а к пятой — в транзакционный запрос с уточнением по срокам доставки. Один и тот же материал попадет в ответ модели на разных стадиях этого диалога, если закрывает все три уровня.
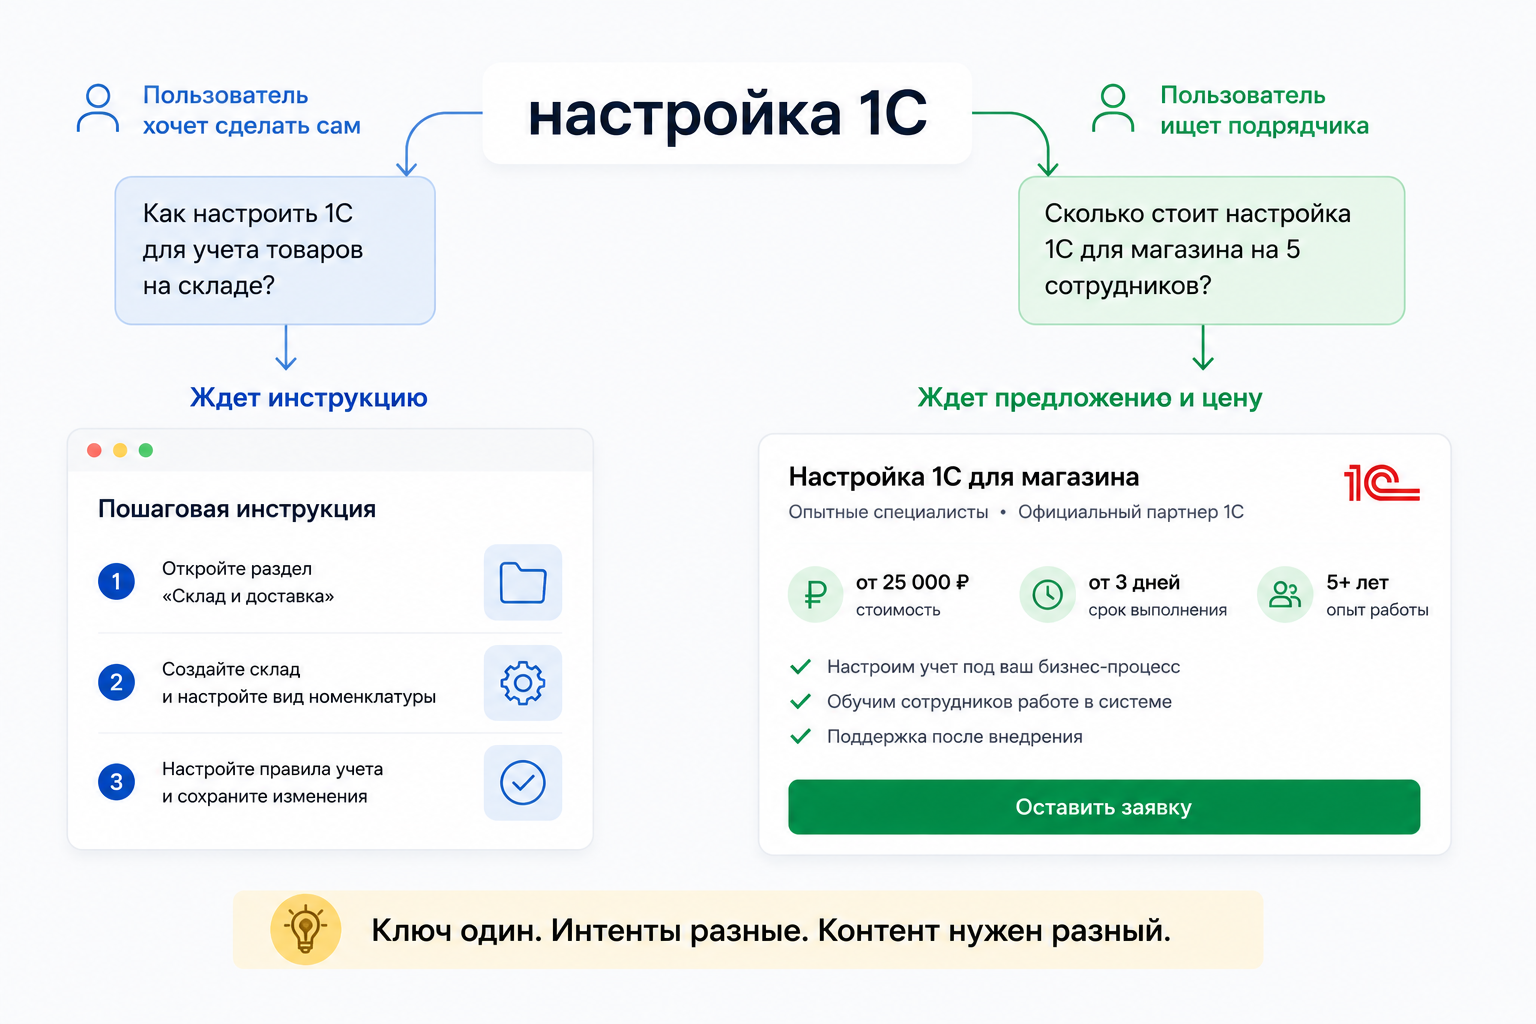
Обратный случай — один промпт с несколькими интентами внутри. Фраза «настройка 1С» скрывает и того, кто ищет инструкцию, и того, кто хочет заказать услугу. Определите интент по выдаче: посмотрите, какие страницы Яндекс держит в топе по фразе и что ChatGPT отвечает на прямой вопрос с той же темой. Совпадение форматов подскажет, чего ждет пользователь.
Чем промпт отличается от обычного поискового запроса
Средний запрос в Яндексе и Google — 2-4 слова. Промпт для нейросети редко укладывается в эти рамки. Разница не только в длине.
Поисковая система сопоставляет слова запроса с индексом документов: находит вхождения, словоформы, синонимы из своих словарей и ранжирует страницы. Нейросеть обрабатывает промпт как реплику собеседника: вычленяет роль, ограничения, критерии выбора и формирует ответ, собирая его из нескольких источников. Первая возвращает ссылки, вторая — готовое решение с аргументацией.
Отсюда три практических следствия для контента:
- Число итераций. Поиск завершается за один шаг: ввел запрос — перешел по ссылке. Диалог с нейросетью растягивается на 3-7 реплик, и на каждой модель отсекает часть вариантов. Материал, который отвечает на уточняющие вопросы так же конкретно, как на первый, остается в ответе дольше.
- Единица оптимизации. Под поисковый запрос вы оптимизируете страницу целиком: title, H1, вхождения. Под промпт работает отдельный фрагмент — абзац или раздел, который модель может процитировать без правок.
- Отсутствие клика. Пользователь получает ответ и не переходит на сайт. Упоминание бренда в тексте ответа становится самостоятельным результатом, даже когда трафика по нему нет.
Как AI-поиск понимает смысл запроса
AI-поиск складывается из трех механизмов, работающих одновременно.
Семантический разбор. Модель переводит промпт в векторное представление смысла и сопоставляет его с векторами фрагментов текста — из обучающей выборки или из свежей выдачи, если у системы есть доступ в интернет — как у Perplexity, поисковых режимов ChatGPT и Gemini. Точное вхождение фразы для этого не требуется: «сколько стоит логотип» и «бюджет на разработку фирменного стиля» дают близкие векторы.
Классические факторы ранжирования. Релевантность теме, авторитетность домена, свежесть данных. Модель с поиском сначала получает список источников от поисковой системы и только потом строит ответ, поэтому позиции в органике продолжают влиять на попадание в AI-выдачу.
Генеративная сборка. Модель сводит информацию из нескольких документов в один текст. На этом шаге выигрывает источник, из которого проще извлечь конкретный факт: цену, срок, характеристику, шаг инструкции. Страница с абзацем «мы предлагаем гибкие условия сотрудничества» не дает модели ничего для сборки, а вот страница со строкой «монтаж от 1200 ₽/м², срок выезда — 2 рабочих дня» дает готовый фрагмент.
В июле 2026 года мы составили первый рейтинг GEO-факторов: девять экспертов оценили 43 сигнала, влияющих на видимость бренда в ответах нейросетей. Набор сигналов шире, чем в классическом SEO, и заметная часть относится не к сайту, а к внешним упоминаниям бренда.
Почему классических ключевых слов недостаточно для AI-поиска
Семантическое ядро по частотности покрывает формулировки, но не покрывает задачи
По ключу «настройка 1С» вы соберете частоту и словоформы, но не увидите, что за фразой стоят два разных читателя с несовместимыми ожиданиями — один ждет инструкцию, второй хочет прайс.
Второе ограничение — длина
Ядро из фраз в 2-3 слова не пересекается с формулировками, которые пользователи адресуют нейросетям. Реальные промпты содержат бюджет, регион, объем, сроки, состав команды — параметры, которых в Вордстате нет.
Третье — механика вхождений перестает работать
Текст с трехкратным повторением ключевой фразы не получает преимущества у генеративной модели: она не считает вхождения, а ищет прямой ответ. Переоптимизированный абзац, где ключ вставлен в ущерб смыслу, наоборот, снижает шанс на цитирование — из него сложнее вытащить чистый факт.
По прогнозу Gartner, к 2026 году объем запросов к традиционным поисковикам сокращается примерно на четверть за счет перехода аудитории к чат-ботам и ассистентам. Часть спроса не исчезает, а меняет форму, и семантика должна догнать эту форму: к ядру ключевых слов добавляется ядро промптов.
Как собирать семантику на основе интентов и промптов
Соберите ядро промптов в пять заходов.
- Выпишите реальные формулировки. Источники: переписка в чате поддержки, вопросы в комментариях, письма от клиентов, поисковые подсказки Яндекса и Google, разделы FAQ конкурентов, отзывы на маркетплейсах. В отзывах люди описывают ситуацию своими словами — это ближе всего к тому, как они разговаривают с нейросетью.
- Сгруппируйте по интентам. Объединяйте формулировки по задаче, а не по общим словам. «Сколько стоит внедрение» и «какой бюджет закладывать на запуск» уходят в один кластер, «как настроить самому» — в другой, хотя лексика частично совпадает.
- Достройте ключи до промптов. Возьмите частотный ключ и добавьте контекст: из «упаковка для интернет-магазина» получится «посоветуй поставщика картонной упаковки для интернет-магазина одежды, тираж от 500 штук в месяц, нужна печать логотипа». Проверка простая: если фразу можно произнести, например, вслух Алисе без правок, промпт готов.
- Прогоните промпты через нейросети. Задайте каждый ChatGPT, YandexGPT, Perplexity и Gemini. Зафиксируйте, называют ли они ваш бренд, каких конкурентов упоминают и на какие сайты ссылаются. Повторите прогон несколько раз — ответы не детерминированы, две попытки подряд дают разный порядок брендов.
- Расставьте приоритеты. Наверх поставьте темы с высокой частотой промптов и нулевой видимостью бренда: там прирост будет заметнее всего.
Первый и третий шаги закрывает генератор промптов Пиксель Тулс. Вы указываете бренд, виды деятельности и регион, выбираете режим генерации — по продуктам, аудиториям, интентам или поисковым сущностям — и получаете от 5 до 20 промптов на каждый продукт, уже разбитых по тематическим группам и кластерам, с опцией определения частот. Список выгружается и идет дальше в проверку видимости.
Как адаптировать контент под семантику AI-поиска
Переделайте текст так, чтобы модель могла взять из него готовый фрагмент.
- Отвечайте в первом предложении раздела. Не подводите к ответу через три абзаца вступления — вынесите его вперед, детали дайте ниже.
- Ставьте вопросы в заголовки. H2 «Сколько стоит внедрение CRM для команды из 10 человек» совпадает с промптом буквально, «Стоимость решения» — нет.
- Давайте цифры. Цена, срок, объем, гарантия, состав работ. Абзац без единого числа модель почти не использует при сборке ответа.
- Внедрите разметку Schema.org в формате JSON-LD: Article для статей, FAQPage для блока вопросов, HowTo для инструкций, Organization и Person для издателя и автора. Разметка не гарантирует цитирование, но снимает с модели необходимость угадывать роль каждого блока.
- Подпишите материал автором с датой. Публикации «от редакции» проигрывают в чувствительных тематиках — финансах, медицине, праве, — где требования к авторитетности источника выше.
- Обновляйте цифры. Прайс годичной давности обесценивает страницу целиком: модель, встретив расхождение с другими источниками, выберет более свежий.
Как оценивать видимость контента в ответах нейросетей
Ранжированного списка документов в ответе нет, поэтому измеряйте факт упоминания и его качество.
- Видимость бренда — процент ответов, где нейросеть назвала компанию. Считайте по каждой модели отдельно: 40% в среднем могут складываться из 71% в ChatGPT и нуля в Алисе AI.
- Доля голоса (Share of Voice) — упоминания бренда, деленные на упоминания всех отслеживаемых конкурентов, умноженные на 100%. Показывает место на рынке, а не собственную динамику: видимость может расти вместе с конкурентами, и тогда доля стоит на месте.
- Позиция и роль в ответе. Десять упоминаний в конце списка без ссылки работают слабее трех в первой строке рекомендации. Вместе с номером фиксируйте роль: основная рекомендация, альтернатива, пример, объект сравнения.
- Тональность. «Лидер сегмента» и «популярный, но с сырым интерфейсом» — оба упоминания, эффект на выбор противоположный. Отдельно прогоняйте критические промпты вида «какие недостатки есть у X»: они показывают, что получит человек, который ищет причины отказаться.
- Источники цитирования. Сайты, которые модель приводит как основание ответа. Этот список превращается в медиаплан: публикуйтесь там, где нейросеть уже берет данные.
- Разбивка по моделям и регионам. ChatGPT, YandexGPT, Алиса и Perplexity отвечают на один промпт по-разному, региональная выдача расходится сильнее. Для локального бизнеса это отдельный срез.
Зафиксируйте пул промптов и не меняйте его между замерами, делайте несколько прогонов на каждый промпт, ведите разбивку по нейросетям и отдельно фиксируйте тональность. Модуль видимости брендов в нейросетях от Пиксель Тулс закрывает этот цикл: прогоняет пул промптов, сравнивает ответы за разные даты, показывает источники и упоминания бренда в них, отслеживает до 100 конкурентов и сводит данные по конверсии трафика из нейросетей.
Частые вопросы
Нет. Ядро ключевых слов остается основой трафика из Яндекса и Google, а модели с поиском берут источники из той же органической выдачи. Ядро промптов дополняет его, а не заменяет.
Для среднего бизнеса рабочий объем — 50–150 промптов в 10–20 кластерах. Дальше список растет по итогам первых замеров видимости.
Посмотрите топ Яндекса по этой фразе и ответ нейросети на прямой вопрос с той же темой. Формат материалов, которые вы увидите, и есть ответ на вопрос об интенте.
Прямой связи нет. Модель выбирает источник с самым четким ответом на конкретный вопрос, а не самый длинный материал. Статья на 30 тысяч знаков без единой цифры проиграет карточке на 3 тысячи знаков с ценами и сроками.
Да, если он структурирован под прямые ответы, размечен через Schema.org и содержит актуальные данные. Такой материал одновременно ранжируется в органике и попадает в источники нейросетей.
Раз в квартал в стабильных нишах, раз в 1–2 месяца в финтехе, e-commerce и туризме. Внеплановый повод — выход новой версии модели: обновление алгоритма сдвигает видимость по уже проверенным промптам.
- 💬 Что такое промпт
- 🔍 Отличия промптов от запросов
- 🧩 Как собирать семантику промптов