
Какие источники влияют на ответы ChatGPT, Gemini и Алисы AI
Задайте один вопрос трем нейросетям — и получите три разных списка компаний. ChatGPT назовет одни бренды, Gemini — другие, Алиса AI — третьи, и пересечение может оказаться нулевым.
Дело не в качестве моделей: просто они отвечают, опираясь на разные наборы данных.
Вопрос давно вышел за пределы теории. По исследованию пути пользователя за 2026 год:
Ответ формируется до того, как человек дошел до сайта, и решает его формулировка вместе с набором источников, которые модель взяла в работу.
Разбираем, откуда нейросети берут информацию, почему один и тот же промпт дает разные ответы в разные дни и что из этого можно изменить со стороны бизнеса.
Почему нейросети по-разному отвечают на один вопрос
Расхождение дают четыре причины:
- Доступ к интернету. Perplexity, поисковые режимы ChatGPT и Gemini, Алиса AI и Google AI Overview обращаются к живой выдаче. Модель без поиска отвечает по памяти обучения: она не знает, что компания сменила тарифы месяц назад.
- Разные индексы. Алиса AI строит ответ на выдаче Яндекса, AI Overview — на выдаче Google, Perplexity использует собственный обход плюс сторонние поисковые API. Один запрос уходит в три разные базы документов, и списки источников расходятся еще до генерации.
- Недетерминированная генерация. Модель выбирает следующее слово вероятностно. Два прогона одного промпта подряд дают разный порядок брендов, а иногда и разный состав списка. Замер по одному ответу показывает случайную точку.
- Контекст сессии. История диалога, загруженные файлы, сохраненные предпочтения и регион меняют ответ. Пользователь, который до этого спрашивал про бюджет до 15 тысяч, получит другой список, чем тот, кто задал вопрос с чистого листа.
Какие типы источников используют AI-системы
Информация приходит в ответ по четырем каналам:
- обучающая выборка — тексты, на которых модель училась: веб-страницы, книги, документация, код, форумы; знания из нее встроены в веса и доступны без интернета;
- живая выдача — документы, которые система получает в момент запроса и цитирует со ссылками; здесь работает механика RAG: сначала поиск по индексу, потом сборка ответа из найденных фрагментов;
- контекст пользователя — файлы в диалоге, предыдущие реплики, память сервиса о человеке;
- внешние инструменты — подключенные сервисы, к которым модель обращается за данными: калькуляторы, базы, API компаний.
Для бизнеса значение имеют первые два. Внутри живой выдачи площадки делятся по типам:
- интернет-магазин;
- сайт услуг;
- контентный проект;
- СМИ;
- медиаплатформа с пользовательским контентом;
- агрегатор;
- справочник;
- рейтинг;
- отзовик;
- доска объявлений;
- сервис;
- социальная сеть;
- форум;
- блог;
- мессенджер.
Разбивка нужна для медиаплана: она показывает, какой тип площадок кормит ответы в вашей нише. Бренд может стабильно попадать в ответы через отзывы на агрегаторах, а собственный домен в источниках не появляться ни разу — тогда работа с корпоративным блогом видимость не сдвинет.
Чем обучающие данные отличаются от источников из интернета
Обучающая выборка формирует общее представление модели о рынке. Она объясняет, почему нейросеть без доступа к сети называет бренды, известные два года назад, и почему компания, о которой в интернете почти не писали, не появляется в ответе даже при идеальном сайте.
Три следствия для работы:
- данные устаревают до следующего цикла обучения — ошибка про вашу компанию, попавшая в веса, живет до переобучения модели, исправить ее со стороны бизнеса нельзя;
- ссылку на источник такой ответ не дает — модель воспроизводит утверждение, не указывая происхождение, потому что внутри весов отдельного документа уже нет;
- проверить состав выборки невозможно — разработчики публикуют общие описания корпусов без перечня доменов и дат.
Живая выдача устроена иначе. Она обновляется в тот же день и сопровождается списком источников. Публикация, вышедшая вчера, может попасть в ответ сегодня, если страница проиндексирована и стоит в топе по теме.
Быстрый результат дает присутствие в индексе: материалы на площадках, которые модель цитирует прямо сейчас. Попадание в обучающую выборку — следствие долгого накопления упоминаний, управлять им напрямую нельзя.
Разделить два слоя в замере просто. Задайте вопрос о компании модели с отключенным поиском и той же модели с поиском. Первый ответ показывает, что о вас записано в весах: помнит ли модель профиль компании, отрасль, продукты, не путает ли с однофамильцами. Второй показывает работу с индексом.
Пустой ответ без поиска при уверенном ответе с поиском означает, что бренд живет только в свежей выдаче, и любое проседание позиций сразу обнулит видимость.
Прием работает на ChatGPT, Gemini и других моделях с переключаемым поиском: у Алисы AI и Google AI Overview поиск отключить нельзя, там оценивается только работа с индексом.
Как контекст диалога, файлы и данные пользователя влияют на ответ
Четыре фактора меняют ответ еще до обращения к источникам:
- загруженный файл получает приоритет над сетью — человек прислал прайс конкурента и попросил сравнить, и модель опирается на этот документ, а страницы из выдачи отходят на второй план;
- каждая реплика сужает шорт-лист — общий вопрос про CRM дает список из десяти систем, уточнение про интеграцию с Telegram отсекает половину, ограничение по бюджету оставляет две-три позиции;
- регион меняет выдачу под капотом — один промпт из Москвы и из Новосибирска уходит в поиск с разной геопривязкой, локальные компании появляются только в своем регионе;
- сохраненные предпочтения работают как персонализация — человек, который однажды сказал, что работает в строительстве, получит примеры из своей отрасли без повторного уточнения.
Материал, отвечающий на уточняющие вопросы так же конкретно, как на первый, держится в ответе дольше. К третьей реплике решение принято, и в него попадают компании, прошедшие все фильтры.
Проверять видимость нужно в чистой сессии, без истории и загруженных файлов, иначе замер покажет реакцию модели на ваш собственный контекст.
Как нейросети выбирают и оценивают источники
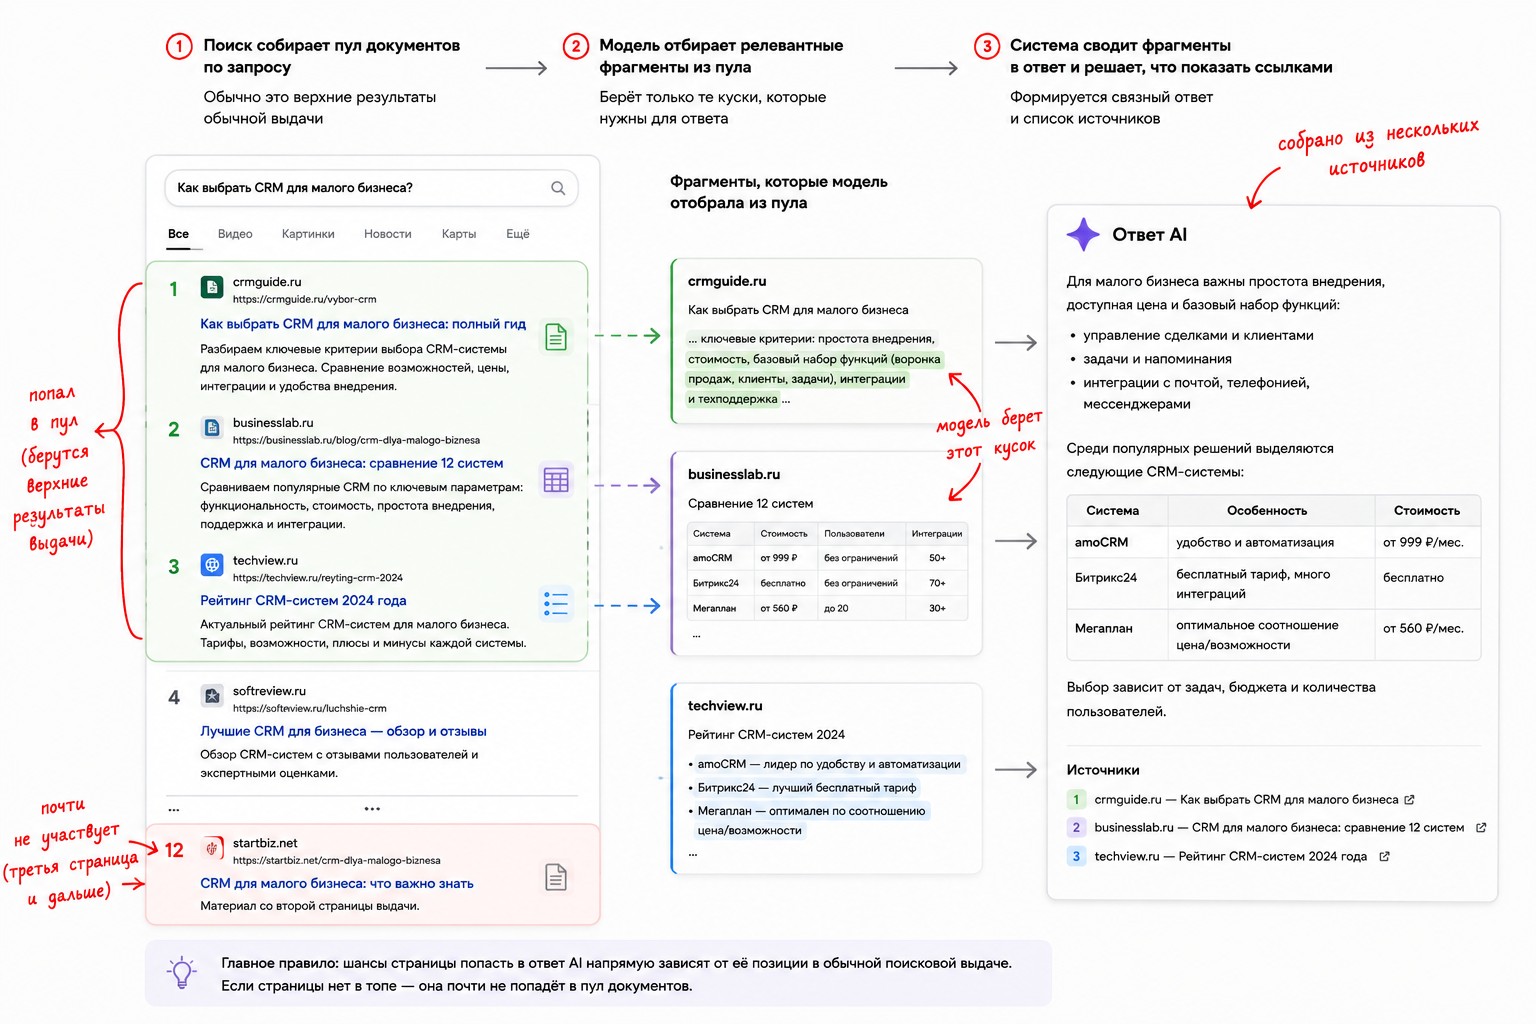
Формулы отбора ни OpenAI, ни Google, ни Яндекс не публикуют. Наблюдаемая механика складывается из трех шагов:
- Поисковая подсистема собирает пул документов по запросу — обычно это верхние результаты обычной выдачи.
- Модель отбирает из пула фрагменты, релевантные конкретной формулировке.
- Система сводит фрагменты в связный ответ и решает, какие источники показать ссылками.
Первый шаг объясняет главное правило: шансы страницы зависят от ее позиции в обычной выдаче. Пул документов собирается из верхних результатов, и материал с третьей страницы туда почти не попадает. Perplexity и собственные краулеры моделей работают шире поисковой десятки, но и там приоритет у страниц с высокой поисковой видимостью.
 На втором шаге выигрывает текст, из которого проще вытащить готовый ответ. В июле 2026 года Пиксель Тулс сформировал рейтинг факторов ранжирования. Верх списка выглядит так:
Проценты здесь означают силу влияния по оценке экспертов, а не вероятность цитирования конкретной страницы.
Опрос АКАР и АРИР, проведенный в том же месяце, дал похожую тройку по мнению специалистов рынка:
- экспертность источника — 57%;
- структурированность материала — 53%;
- наличие прямых ответов на вопросы — 50%.
Оба исследования сходятся в одном: вверху шкалы стоят форматы, из которых модель собирает готовую рекомендацию, — рейтинги, подборки, четкие определения, списки и таблицы. Технические приемы вроде специальных файлов для нейросетей остались внизу. При этом обычное SEO из уравнения не выпадает: SEO страниц с рейтингами получило 86,7%, доступность для краулеров — 84,4%.
Какие сайты и площадки чаще попадают в AI-ответы
По рейтингу источников нейросетей Пиксель Тулс разобрал 2 716 313 источников, использованных в 89 629 ответах нейросетей. Первые места по встречаемости заняли площадки с пользовательским контентом, классические медиа остались ниже. Самое цитируемое СМИ стоит на шестом месте и уступает блог-платформе в полтора раза.
Причина в форме подачи. Материал на UGC-площадке почти всегда написан как ответ на конкретный вопрос: сколько это стоит, как мы это сделали, чем X отличается от Y. Медийный текст построен как история — лид, интрига, контекст, суть в середине. Человек дочитает, модель заберет фрагмент поближе к вопросу, и фрагмент окажется с другого сайта.
Вторая причина — доступность. Пейволл, подгрузка текста скриптами и антибот-защита закрывают материал от читателя без подписки, а заодно от краулеров, которые собирают базу для ответов.
По типам площадок в верхней части рейтинга держатся медиаплатформы, сервисы и агрегаторы. Данные обновляются, актуальные доли по каждой нейросети смотрите в том же дашборде: там есть фильтры по Алисе, Google AI Overview и Perplexity и по типу площадки.
В B2B-услугах ответ собирается из отраслевых обзоров, рейтингов агентств и кейсов на профильных платформах. В e-commerce вверх выходят маркетплейсы, агрегаторы и отзовики: модель берет оттуда цену, наличие и оценку товара. В услугах с локальной привязкой — справочники и карты. Проверять состав нужно по своим промптам, средние доли по рынку задают только ориентир.
Приоритет площадок для медиаплана по убыванию отдачи:
- платформы с пользовательским контентом и экспертными материалами — они держат верх рейтинга цитируемости;
- рейтинги, подборки и каталоги по вашей теме;
- отраслевые медиа с тематической репутацией;
- справочники, карты и отзовики для локального бизнеса;
- классические СМИ.
Критерий отбора один — страница, на которой выйдет материал, должна ранжироваться в поиске. Известность издания сама по себе присутствия в AI-ответах не дает: топовое СМИ в рейтинге цитируемости стоит шестым и уступает блог-платформе в полтора раза.
Почему источники зависят от темы, региона и формулировки запроса
Один и тот же бренд получает разную видимость в разных срезах:
- Тема. В нишах с высокой ценой ошибки — медицина, финансы, право — модели чаще опираются на официальные порталы и сайты с подтвержденной экспертизой. В бытовых темах вверх выходят отзовики и форумы.
- Регион. Локальный бизнес виден только в своей геопривязке. Для компании с филиалами в пяти городах это пять отдельных замеров вместо одного усредненного.
- Формулировка. «Лучшие CRM» и «какую CRM выбрать отделу продаж из пяти человек» уходят в разные пулы документов. Первый запрос вытянет рейтинги, второй — кейсы и сравнения под конкретный сценарий.
- Нейросеть. Российский рынок держится на Алисе AI: на нее приходится 64,83% трафика из нейросетей по выборке из 2921 сайта за период с июля 2025 по июнь 2026. Замер по одному ChatGPT покажет картину, которая к российской аудитории отношения почти не имеет.
- Язык. Запрос на английском по той же теме уходит в англоязычный сегмент индекса, и в источники попадают зарубежные площадки. Для компаний с экспортом или международными клиентами это отдельный набор промптов и отдельный медиаплан.
Отсюда требование к методике: разбивка по нейросетям, регионам и группам промптов обязательна, сводный процент без разрезов скрывает нули в половине сегментов.
Как определить, на каких источниках основан ответ нейросети
Начните с ручной проверки — она показывает контекст и стоит нуля.
Задайте промпт в чистой сессии, без истории и загруженных файлов. Разверните блок ссылок под ответом: Perplexity, Алиса AI и Google AI Overview показывают источники прямо в интерфейсе, ChatGPT — в поисковом режиме. Зафиксируйте домены, конкретные URL и место вашего бренда в списке. Повторите промпт три-пять раз: состав источников будет меняться, и разброс сам по себе информация.
Что проверять по каждому ответу:
- какие домены попали в источники и есть ли среди них ваш;
- упоминается ли бренд в тексте ответа или только в ссылках;
- на каком месте он стоит и в какой роли — рекомендация, альтернатива, пример;
- какие конкуренты названы рядом;
- корректны ли цена, условия и описание продукта.
Ручной прогон работает до 10–15 промптов. Дальше нужен сервис: двадцать промптов на пяти нейросетях по три повтора — это триста прогонов, и вручную такой объем не снять.
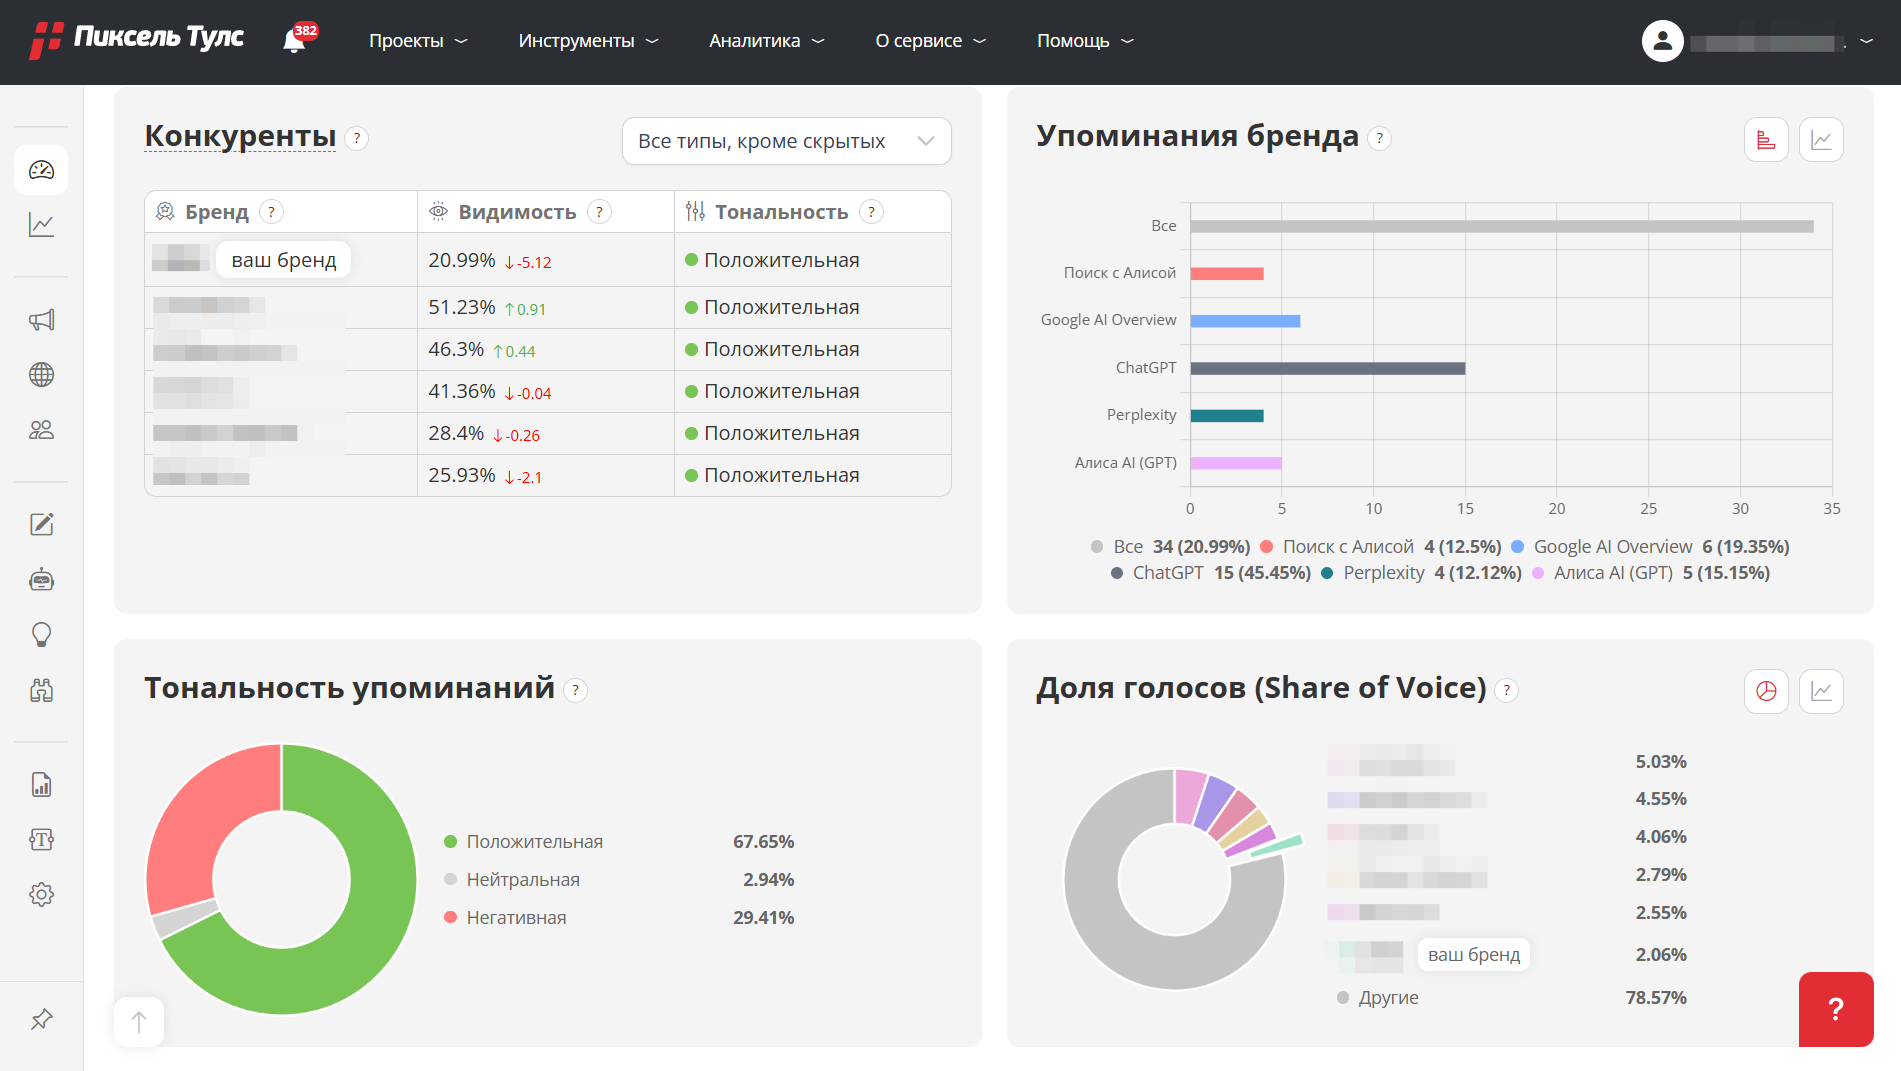
Инструмент анализа видимости брендов в нейросетях от Пиксель Тулс прогоняет пул промптов по расписанию, сохраняет ответы, показывает источники и проверяет, упоминается ли бренд на страницах-источниках. Сравнение ответов за разные даты показывает, что именно изменилось в формулировке между замерами.
Отдельная проверка — доступность вашего сайта для нейросетей:
- боты не закрыты в robots.txt;
- текст отдается в HTML, а не подгружается скриптом;
- антибот-защита не блокирует обход;
- контент виден из-за пейволла хотя бы в объеме лида и фактуры.
Фактор доступности эксперты оценили в 84,4%: материал может быть безупречным, но если краулер до него не дошел, источником он не станет.
Как бизнесу влиять на источники ответов AI
Работа делится на два контура с разной скоростью отдачи.
| Работа с индексом | Работа с обучающей выборкой | |
|---|---|---|
| Что делаете | Размещения на цитируемых площадках, рейтинги, сравнения, структура своих страниц | Накопление упоминаний бренда в открытых источниках |
| Когда виден результат | От нескольких дней до пары месяцев | Циклами переобучения моделей, сроками не управляете |
| Чем измеряется | Доля ответов с упоминанием, домен в источниках | Узнаваемость бренда в ответах без доступа к сети |
| Кто отвечает | SEO, PR, редакция | Все каналы маркетинга суммарно |
Практический порядок действий:
- Снимите базовый замер до начала работ. 50–100 вопросов по ключевым темам, прогон по нейросетям, фиксация площадок-источников и своего места среди них.
- Соберите медиаплан из полученного списка. Ориентируйтесь на площадки, которые модель уже цитирует по вашей теме; отраслевая привычка размещаться в конкретном издании здесь роли не играет.
- Займитесь рейтингами и подборками. Самый сильный формат по оценке экспертов. Условие одно: страница рейтинга должна стоять в топе поиска, иначе для модели ее нет.
- Переделайте свои страницы под извлечение фрагментов. Ответ в первом предложении раздела, вопрос в заголовке, цифры вместо общих формулировок, сравнения таблицей, блок вопросов и ответов внизу.
- Подпишите материалы автором с должностью и датой обновления. В финансах, медицине и праве публикации от редакции проигрывают именной экспертизе.
- Обновляйте цифры по графику. Прайс годичной давности обесценивает страницу: встретив расхождение с другими источниками, модель выберет свежий.
Отдельно стоит распространенная ошибка в распределении усилий. Команды продвигают собственный сайт, хотя в ответ модель тянет чужие подборки. Рабочий подход — продвигать страницы, на которых бренд уже упомянут: помогать площадке дорабатывать материал, добавлять структуру и цифры, поднимать эту страницу в поиске. Рейтинг вне топа выдачи для нейросети не существует, и ваше место в нем значения не имеет.
По кейсам конференции «GEO-кейс 2026» первые сдвиги видимости фиксируются через полтора-два месяца, выход на заявленные показатели занимает от четырех до шести месяцев. Быстрее двигаются промпты, по которым бренд уже появлялся хотя бы в одном замере: модель знает компанию, вопрос в закреплении. Промпты с нулевой видимостью требуют новых размещений и разгоняются медленнее.
Частые заблуждения об источниках нейросетей
«Нейросеть читает интернет в реальном времени»
Только модели с подключенным поиском. Остальные отвечают по обучающей выборке, и данные там могут отставать на год и больше.
«Достаточно попасть в топ Яндекса, дальше нейросеть подтянет»
Топ дает попадание в пул документов. Дальше модель отбирает фрагменты, пригодные для ответа, и страница без прямых формулировок остается за бортом.
«llms.txt обязателен»
В опросе экспертов фактор получил самую низкую оценку из сорока трех — 21,1%, и в исследовании прямо назван мифом. Ставить его в план работ выше рейтингов и упоминаний не стоит.
«Упоминание бренда всегда в плюс»
«Лидер сегмента» и «популярный, но с сырым интерфейсом» — оба упоминания, но эффект на выбор противоположный. Тональность стоит считать отдельной метрикой.
«Пресс-релиз попадет в ответы»
Анонс ради анонса модели игнорируют: из него нечего собрать. Работают релизы с фактурой — цифрами, условиями и сравнением с рынком.
«Один прогон показывает позицию»
Генерация недетерминирована, поэтому два запуска подряд могут дать разный список. Вывод строится на трех-пяти повторах по неизменной методике.
«Если трафика из нейросетей мало, канал не работает»
Ни Яндекс, ни Google не выделяют переходы из блока Алисы и AI Overview в отдельный отчет, поэтому счетчики систематически занижают вклад канала. Стоит учитывать брендовый спрос и сами ответы: клики здесь показывают лишь часть картины.
Вопросы и ответы
Из двух мест. Обучающая выборка — тексты, на которых модель училась, знания из них встроены в веса и доступны без интернета. Поисковый режим — живая выдача в момент запроса, такие ответы сопровождаются ссылками. Без включенного поиска ChatGPT отвечает по памяти, и данные там отстают на месяцы.
Генерация вероятностная: два прогона подряд дают разный порядок и состав ссылок. Плюс меняется сама выдача, из которой собирается пул документов. Устойчивым считайте то, что повторяется в трех-пяти прогонах.
Напрямую — нет. Состав и сроки обучения определяет разработчик, заявок на включение не существует. Влияет объем упоминаний бренда в открытых источниках, накопленный за годы. Управляемый контур — живая выдача, туда публикация попадает за дни.
В разборе 2 716 313 источников из 89 629 ответов вверху оказались площадки с пользовательским контентом. Самое цитируемое классическое издание стоит шестым и уступает блог-платформе в полтора раза. Причина в подаче — на UGC-площадках материал написан как ответ на конкретный вопрос.
Влияет на первом шаге: пул документов собирается из верхних результатов выдачи. Страница вне топа в пул не попадет. Дальше решает содержание — модель отбирает фрагменты, из которых можно собрать ответ.
Задайте промпт в чистой сессии и разверните блок источников под ответом. Повторите три-пять раз, зафиксируйте домены и свое место в списке. От 10–15 промптов ручная проверка перестает масштабироваться, дальше нужен сервис мониторинга.
Закрытие лишает шанса попасть в источники. Если контент платный, разумный компромисс — отдавать структурированный лид и фактуру, оставляя за подпиской авторскую аналитику.
Да, они работают с разными индексами: Алиса опирается на выдачу Яндекса, Google AI Overview — на Google, Perplexity использует собственный обход. Для российского рынка замер только по ChatGPT нерепрезентативен: на Алису AI приходится 64,83% трафика из нейросетей.
Живая выдача обновляется постоянно, состав ссылок может отличаться в соседних замерах. Полный срез снимайте раз в месяц, критичные промпты проверяйте еженедельно, внеплановый замер — после крупной публикации или обновления модели.
Полезные материалы


